Conseil indépendant en génétique quantitative et bio-informatique

Prenez des décisions de sélection éclairées à partir de vos données génotypiques et phénotypiques.

Sachez quelles lignées retenir pour la suite, quels signaux génétiques approfondir et jusqu’où vous fier à vos modèles de prédiction, à partir des données dont vous disposez déjà. Pour les équipes de sélection, les entreprises d’agro-biotechnologie et les groupes de recherche : périmètre et prix fixes, résultats en quelques semaines, et le code vous appartient.

Diagramme de Manhattan illustratif Résultats simulés d’une étude d’association portant sur 4 288 marqueurs répartis sur 12 chromosomes. Une association sur le chromosome 5 dépasse le seuil de Bonferroni et un signal plus faible sur le chromosome 10 reste en dessous. Données simulées, ne provenant d’aucun client ni d’aucun jeu de données de recherche. 0 2 4 6 8 10 −log₁₀(p) Seuil de Bonferroni 1 2 3 4 5 6 7 8 9 10 11 12 Chromosome
DoctoratGénétique et amélioration des plantes
PostdocIPK, Institut Leibniz de génétique végétale et de recherche sur les plantes cultivées, Allemagne
25+publications dans des revues internationales, dont des revues Nature Portfolio (Nature Communications, Scientific Reports)
20+bourses et distinctions internationales
6 600+accessions de banque de gènes génotypées à partir des données brutes, ploïdies de 2x à 6x, pour des partenaires dont trois entreprises de sélection
EN · FRlangues de travail. Accord de confidentialité sur demande.

Vos enjeux

Quelle décision devez-vous prendre ?

Partez de la décision, pas de la méthode. Vous obtenez l’analyse que votre question, votre dispositif d’essai et vos données exigent, sans payer pour ce dont vous n’avez pas besoin.

Sélection

Quelles lignées retenir pour la prochaine étape ?

Vous disposez de données d’essais menés sur plusieurs sites et plusieurs saisons, et une réunion de sélection approche.

Vous obtenez un classement des lignées candidates, la stabilité de chacune selon les environnements et la part génétique de leurs différences, pour faire avancer les lignées sur leur valeur génétique et non sur une bonne saison.

Signaux génétiques

Quels signaux approfondir ?

Une étude d’association pangénomique (GWAS) a produit une liste de signaux, ou vous disposez des données sans avoir le temps de mener l’analyse.

Vous identifiez les associations robustes, celles qui ne le sont pas, et l’endroit où votre budget de validation sera le mieux investi.

Prédiction génomique

Peut-on se fier à ce modèle ?

Vous vous apprêtez à utiliser la prédiction génomique pour décider quelles lignées seront écartées avant les essais au champ.

Vous obtenez sa capacité prédictive mesurée dans les conditions d’utilisation prévues, sur de nouvelles familles, de nouveaux environnements ou le prochain cycle, pour savoir si vous pouvez vous y fier avant d’écarter de bonnes lignées.

Pour les équipes de recherche : des questions d’analyse ciblées résolues, des rapports aux organismes financeurs livrés et des manuscrits finalisés.

Pourquoi travailler avec moi

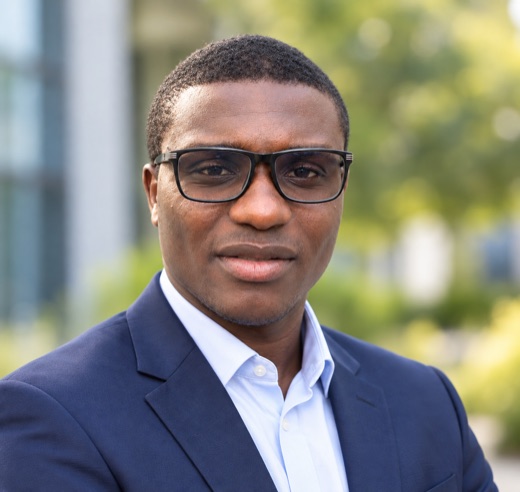
Portrait du Dr Konoutan Medard Kafoutchoni
Dr Konoutan Medard
Kafoutchoni

Un généticien spécialisé en sélection végétale, qui maîtrise aussi la bio-informatique.

Vous bénéficiez des statistiques et de la bio-informatique réalisées par quelqu’un qui sait ce qu’une équipe de sélection fait des résultats : des réponses utilisables dès votre prochain cycle de sélection.

Vos données interprétées avec le regard d’un sélectionneur.

Formé en génétique et amélioration des plantes, je construis l’analyse autour de votre dispositif d’essai, de vos caractères et de vos objectifs de sélection. Vous recevez des décisions dans les termes de votre équipe : quelles lignées, quels caractères, et quel degré de confiance accorder à chacun.

Exemple de rechercheMaïs : sur plus de 700 hybrides et 34 caractères, distinction entre les caractères à privilégier pour la sélection et ceux qu’un panel de marqueurs ne capterait pas.

Un seul interlocuteur, des données de séquençage à la décision.

La bio-informatique et la génétique statistique mobilisent souvent deux spécialistes, et chaque passage de relais coûte du temps et de l’argent. Vous avez un seul interlocuteur, des données brutes de séquençage à la décision de sélection, et rien ne se perd entre les étapes.

Exemple de recherchePomme de terre : plus de 6 600 accessions, des données brutes de séquençage aux génotypes aujourd’hui utilisés par trois entreprises de sélection végétale.

Des données difficiles qui ne bloquent pas le projet.

Ploïdies mixtes, espèces sans génome de référence ni population de sélection, caractères mesurés à partir d’images : j’ai livré des résultats dans chacun de ces cas. Si vos données ressemblent à cela, le projet continue d’avancer.

Exemples de recherchePomme de terre du diploïde à l’hexaploïde. Premier génome de référence de la lentille de terre de Kersting. Plus de 24 000 observations de phénotypage racinaire réduites aux neuf caractères à mesurer.

Des prédictions vérifiées au champ.

Une prédiction n’est utile pour décider que si elle reste fiable là où vous l’utiliserez. Je teste les modèles sur de nouvelles familles et de nouveaux environnements avant que vous ne vous y fiiez, et j’ai suivi des sélections jusqu’aux essais au champ.

Exemple de rechercheLentille de terre de Kersting : gains de sélection par indice confirmés dans plusieurs environnements au champ, avec +21 % pour le poids des graines et −6 % pour le nombre de jours jusqu’à la floraison.

Parcours de recherche

Des méthodes déjà appliquées à des projets de grande ampleur.

Six projets issus de mes travaux de recherche, de la génomique des banques de gènes aux essais au champ et aux plateformes de phénotypage. Chaque exemple précise les situations dans lesquelles cette approche peut vous être utile.

Pomme de terre
banque de gènes

Responsable bio-informatique, projet POMORROW

Plus de 6 600 accessions de pomme de terre, des espèces sauvages aux lignées de sélection et du diploïde à l’hexaploïde : un jeu de données qui met les pipelines standards en difficulté. Je dirige l’ensemble des analyses bio-informatiques du projet : des génotypes fiables obtenus à partir des données brutes de séquençage et utilisés par les partenaires, dont trois entreprises de sélection végétale ; une core collection représentative ; la population d’entraînement pour la prédiction génomique ; un pangénome en graphe de la pomme de terre ; et une GWAS sur l’efficience d’utilisation des nutriments. Pour une entreprise de sélection, cela signifie des génotypes fiables sur du matériel polyploïde et une population d’entraînement choisie pour couvrir votre matériel génétique. Pour une banque de gènes, un programme de pré-sélection ou un caractère coûteux à mesurer, une core collection qui conserve la diversité tout en réduisant le nombre de plantes à phénotyper.

Utile sivous gérez une collection vaste ou diversifiée, travaillez avec du matériel polyploïde ou souhaitez convertir vos données de séquençage en génotypes exploitables.

Maïs
essais au champ

Sélectionner des hybrides de maïs dont la biomasse se convertit plus facilement en bioénergie

La question : peut-on sélectionner, parmi des hybrides issus de variétés locales, ceux dont la biomasse se convertit plus facilement en bioénergie, et accélérer cette sélection grâce à la prédiction génomique ? J’ai analysé des essais de plus de 700 hybrides à quatre voies dans plusieurs environnements, cartographié 34 caractères avec 945 000 SNP et testé la prédiction génomique, y compris sur de nouvelles familles.

Les résultats : la saccharification est polygénique, faite de nombreux petits effets additifs ; les deux loci détectés en expliquent au plus environ 7 %. Avec une validation croisée aléatoire, la capacité prédictive atteignait jusqu’à 0,67 pour les caractères du grain, mais seulement 0,15 pour la saccharification ; elle baissait sur de nouvelles familles, et un second site d’essai apportait peu.

Ce que cela évite à un sélectionneur ou à une entreprise d’agritech : investir dans un panel de marqueurs ou quelques loci cibles pour ce type de caractère. Utilisez la prédiction sur l’ensemble du génome, testez-la sur de nouvelles familles avant de vous y fier, et vérifiez ce qu’un site d’essai supplémentaire apporte avant de le financer.

Utile sivous conduisez des essais dans plusieurs environnements et devez identifier les caractères à privilégier pour la sélection, puis évaluer si la prédiction génomique reste utile sur du nouveau matériel.

Lentille de terre
de Kersting

Développer les outils de sélection d’une légumineuse orpheline, Macrotyloma geocarpum

À partir de ressources génomiques très limitées, j’ai assemblé le premier génome de référence de l’espèce (Nature Communications) et développé les analyses de génétique quantitative nécessaires à sa sélection : estimation de l’héritabilité dans sept environnements au champ, prédiction génomique et sélection par indice. Les gains de sélection ont été confirmés au champ, avec +21 % pour le poids des graines et −6 % pour le nombre de jours jusqu’à la floraison. La plupart des marqueurs DArTseq n’ont pas pu être confirmés par un séquençage indépendant, mais les seuls marqueurs confirmés prédisaient aussi bien, voire mieux, pour 11 caractères sur 15. L’étape pratique pour vos propres marqueurs : un filtre sur le taux d’appel (call rate), qui a permis ici de retrouver 97 % de ce gain sans financer une seconde plateforme de génotypage. Le phénotypage par drone a complété ces analyses avec des caractères mesurés à partir d’images au champ.

Utile sivous travaillez sur une culture peu étudiée ou une population disposant de peu de ressources génomiques, ou souhaitez vérifier la fiabilité de vos marqueurs.

Trois autres : phénotypage racinaire, photosynthèse du tournesol, biofortification du niébé
Racines de caféier
et de cacaoyer

Transformer les images racinaires en caractères utiles à la sélection, groupe de phénotypage végétal automatisé de l’IPK

Le système racinaire influence la capacité d’un porte-greffe à supporter un faible apport d’azote, mais il reste difficile à caractériser. Sur une plateforme de rhizotrons de 378 parcelles du projet BOLERO, 8 espèces de caféier et 3 clones de cacaoyer cultivés sous deux niveaux d’azote ont produit plus de 24 000 observations sur 137 variables. Sur 56 caractères racinaires mesurés à partir d’images, 9 suffisaient à décrire le système racinaire sans redondance ; la longueur racinaire totale a conservé une héritabilité élevée pendant les 66 jours, alors que celle des autres caractères variait avec l’âge des plantes et l’apport d’azote. Six génotypes ont développé un système racinaire plus efficient en conditions de faible apport d’azote, une première liste de porte-greffes candidats. L’étape pratique pour un programme de phénotypage : mesurer moins de caractères, les choisir selon leur héritabilité et fixer le moment de la mesure.

Utile sivotre plateforme de phénotypage produit de nombreux caractères et vous souhaitez identifier ceux qui sont héritables et utiles à la sélection.

Tournesol
physiologie

Quand mesurer les caractères photosynthétiques, GAIN4CROPS (EU H2020)

Sur 222 génotypes de tournesol mesurés avec des fluorimètres portables pendant deux ans et dans trois fenêtres de développement, l’héritabilité était la plus élevée dans la dernière fenêtre pour 8 caractères sur 9, et la moyenne sur la saison était moins héritable que cette fenêtre pour les 9, avec une perte moyenne de 18,5 % de la réponse à la sélection par cycle. La prédiction génomique entraînée dans une fenêtre ne se transférait pas à une autre (capacité prédictive médiane de 0,03, contre 0,37 dans une même fenêtre). La bonne fenêtre dépend de la culture et du caractère et doit donc être définie à partir de vos propres données : c’est l’étape que je réalise pour un client, en identifiant la fenêtre où vos mesures sont les plus héritables et en y entraînant les modèles de prédiction. Une seconde étude a testé la prédiction génomique du point de compensation du CO₂ chez des espèces intermédiaires C3–C4 du genre Helianthus.

Utile sivous mesurez des caractères physiologiques en cours de saison et devez savoir quand les mesurer et s’ils peuvent être sélectionnés.

Niébé
biofortification

GWAS sur la teneur en caroténoïdes des germes de niébé

Sur un panel de 125 accessions de Vigna unguiculata, une GWAS a identifié sept QTL majeurs (R² > 10 %) associés à la teneur en caroténoïdes des germes. L’étape pratique : cribler les parents candidats avec ces marqueurs avant les croisements de biofortification.

Utile sivous souhaitez identifier des marqueurs associés à un caractère d’intérêt pour guider le choix des parents.

Domaines d’expertise

  • GWAS et cartographie de QTL
  • Prédiction et sélection génomiques
  • Analyse G×E
  • Traitement de données GBS / SNP
  • Génomique à ploïdie mixte (2x à 6x)
  • Analyse des données de phénotypage à haut débit
  • Conception de core collection et de population d’entraînement
  • Validation des marqueurs entre plateformes
  • Génétique des cultures orphelines
  • Pipelines R / Python reproductibles

Déroulement de la mission

Quatre étapes, sans surprise sur le coût ni le périmètre.

  1. 01

    Parlez-moi des données et de la décision

    Un court message suffit : la culture, les données disponibles et la décision à prendre. Aucun engagement à ce stade.

  2. 02

    Proposition à périmètre défini

    Vous validez par écrit la question, les méthodes, les livrables et le prix avant le début du travail. Aucun dépassement imprévu.

  3. 03

    Analyse

    Des résultats exploitables : données contrôlées, modèles validés, chaque résultat relié à votre décision.

  4. 04

    Livraison et prise en main

    Le rapport et le code vous sont remis, avec une prochaine étape claire. Votre équipe peut tout réexécuter sans moi.

Ce que vous recevez

Résultats interprétés
Ce que les résultats signifient pour votre décision ou votre question de recherche, en termes clairs.
Des méthodes défendables
Chaque choix analytique et chaque étape de validation sont documentés, pour justifier la décision auprès de votre direction, d’un partenaire ou d’un relecteur.
Code reproductible
Du code R ou Python que votre équipe peut réexécuter sur les données de la saison suivante, sans dépendre de moi.
Des recommandations pour la suite
Quoi tester, valider ou sélectionner ensuite, pour que l’analyse débouche sur une action.

Services et tarifs

Un résultat défini, un prix connu, des données confidentielles.

Avant le début de la mission, vous recevez une proposition écrite précisant la question à traiter, les livrables et le prix. Vos données restent confidentielles, avec un accord de confidentialité (NDA) si vous le souhaitez. Les résultats et le code vous appartiennent. Vous hésitez sur la prestation à choisir ? Commencez par le diagnostic ou décrivez vos données pour que je vous propose une formule adaptée.

Prestations de conseil à périmètre défini, livrables et tarifs en euros
OffreCe que vous obtenezPrix fixe
Diagnostic des données et de l’analyseSachez si vos données et votre plan d’analyse peuvent répondre à votre question avant d’engager un budget. Une séance de travail de 60 minutes sur vos données, votre code ou votre plan d’analyse, puis des recommandations écrites sous 48 heures.248 €
Remise en état de pipelineRemettez en marche un pipeline R/Python défaillant ou à l’arrêt, documenté pour que votre équipe puisse l’exécuter sans son auteur d’origine. Pipeline fonctionnel, documentation et entretien de prise en main.494 €
Sprint d'analyse de donnéesUne réponse claire à une question sur un jeu de données : GWAS, prédiction génomique ou statistiques de phénotypage, avec validation croisée. Résultats, figures, description des méthodes et code, prêts pour décider ou pour rendre compte.755 €
Finalisation des analyses pour un manuscritRelancez un article à l’arrêt : vos données et votre brouillon menés jusqu’à des analyses prêtes pour la soumission, avec figures de publication et sections Méthodes et Résultats.998 €
Core collection et population d’entraînementPhénotypez moins de plantes sans perdre l’essentiel : un sous-ensemble représentatif choisi à partir de vos génotypes, soit une core collection pour une banque de gènes, soit les lignées à phénotyper pour qu’un modèle de prédiction génomique couvre votre matériel génétique. Liste du sous-ensemble, rapport de représentativité et code.750 à 1 500 €
Construction de pipelineRéalisez vos analyses de routine en interne : un pipeline reproductible de GWAS, de sélection génomique, de GBS ou de phénotypage qui vous appartient. Périmètre défini dans la proposition.2 000 à 5 000 €
Forfait mensuel d’analyseUn analyste disponible sans recrutement : 5 à 10 heures par mois pour les équipes qui ont un flux régulier de données. Synthèse mensuelle et réponse prioritaire.400 à 800 € par mois

Le prix du diagnostic est déduit de celui d’une construction de pipeline réservée dans les 30 jours.

Contact

Parlons de vos données.

Envoyez une courte description de vos données, de la culture ou de l’espèce étudiée et de la décision à prendre. Sous deux jours ouvrés, je vous réponds en précisant ce que vos données permettent de trancher et quelle prestation convient, avant tout engagement. Vos données restent confidentielles ; un accord de confidentialité (NDA) est disponible sur demande.

Mentions légales

Politique de confidentialité